
Perché l'intelligenza artificiale rischia di "divorare" se stessa
Più i modelli linguistici si nutrono di contenuti generati dalle macchine, più rischiano di perdere originalità e coerenza. Uno studio coordinato da ricercatori italiani individua un possibile antidoto al collasso dell'IA: privilegiare ciò che sfugge alle previsioni degli algoritmi

Il rischio è che l'intelligenza artificiale finisca per diventare sempre più prevedibile. Che, a forza di imparare da se stessa, perda progressivamente la capacità di produrre risposte originali, ripetendo le medesime parole, gli stessi concetti e, nei casi peggiori, costruendo frasi sempre meno sensate. Un paradosso per una tecnologia che promette di ampliare le frontiere della conoscenza. Eppure, secondo un nuovo studio scientifico, per evitare che l'IA si impoverisca la soluzione potrebbe essere sorprendentemente semplice: insegnarle a confrontarsi con ciò che non si aspetta. La ricerca porta una significativa firma italiana: a condurla, infatti, gli studiosi dell'Istituto di scienza e tecnologie dell'informazione del Consiglio nazionale delle ricerche di Pisa (Cnr-Isti), dell'Università di Pisa e della Scuola Normale Superiore, insieme ai colleghi della Victoria University of Wellington, in Nuova Zelanda.
Il lavoro, pubblicato sulla rivista scientifica ACM Transactions on Intelligent Systems and Technology, affronta uno dei problemi emergenti dell'intelligenza artificiale generativa: il cosiddetto model collapse, ovvero il collasso del modello. Per comprenderlo bisogna partire dal modo in cui funzionano i sistemi linguistici. Modelli come quelli alla base dei chatbot vengono addestrati su enormi quantità di testi, dai quali apprendono strutture, relazioni e regolarità del linguaggio. Ma oggi una porzione crescente dei contenuti che circolano online viene prodotta proprio dall'intelligenza artificiale. Articoli, descrizioni, recensioni, messaggi e pagine web possono così trasformarsi, in una fase successiva, in materiale di addestramento per nuove generazioni di algoritmi.
 Pasquale Raicaldo
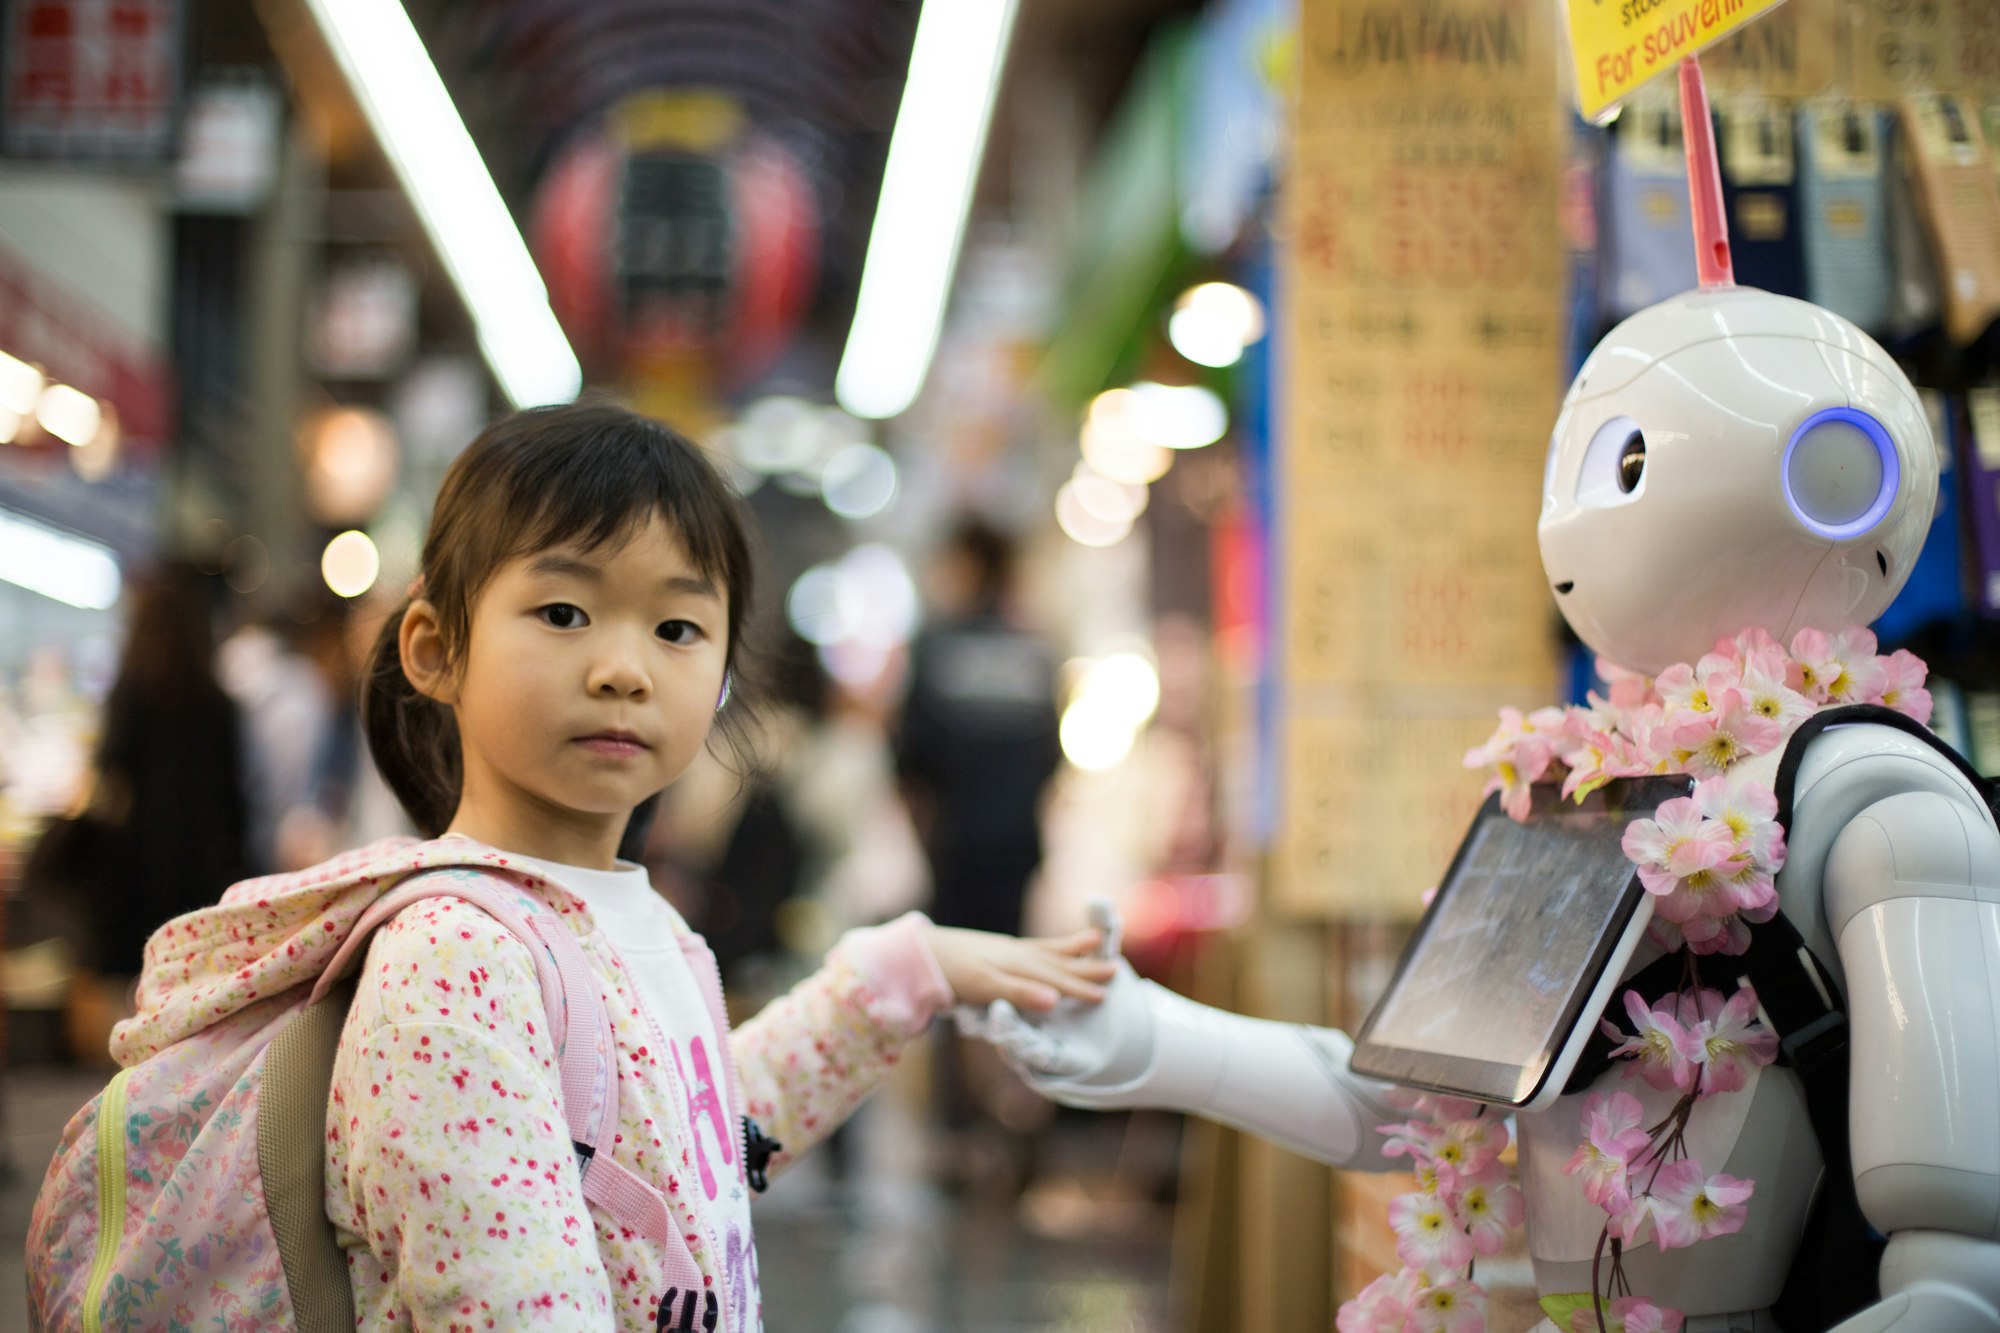
È qui che si nasconde il cortocircuito: le macchine rischiano di imparare sempre più spesso dalle macchine. Un fenomeno che gli scienziati chiamano autofagia, dal greco, letteralmente «mangiare se stessi». Un'immagine efficace per descrivere un sistema che, alimentandosi ripetutamente dei propri prodotti, può finire per impoverire le informazioni sulle quali costruisce le risposte. È un po' come fotocopiare continuamente la fotocopia di una fotografia: a ogni passaggio alcuni dettagli possono andare perduti, mentre gli elementi più evidenti finiscono per dominare l'immagine. Nel caso dell'intelligenza artificiale, a essere progressivamente sacrificata è soprattutto la varietà del linguaggio, insieme alla capacità di produrre contenuti coerenti. «Analizzando quattro modelli di IA generativa, come Llama, sviluppato da Meta, abbiamo osservato che il collasso può manifestarsi in modi diversi. Da un lato, il contenuto generato diventa sempre meno vario e presenta sempre le stesse parole; dall'altro, le frasi generate sono meno coerenti e significative e le risposte meno sensate», spiega Daniele Gambetta, ricercatore post-doc dell'Università di Pisa.
Il problema non riguarda soltanto l'eleganza della scrittura. Se un modello perde progressivamente la capacità di rappresentare la complessità e la diversità delle informazioni, anche l'affidabilità delle sue risposte può risentirne. Un rischio particolarmente rilevante in un'epoca in cui questi sistemi vengono impiegati nella comunicazione, nell'istruzione, nella ricerca e in numerose attività professionali. Come interrompere, allora, questo circolo vizioso? Una possibile soluzione consiste nel distinguere i testi scritti dagli esseri umani da quelli prodotti artificialmente, utilizzando per l'addestramento soltanto i primi. Ma si tratta di una strada sempre più complicata: con il perfezionamento degli algoritmi, riconoscere con certezza l'origine di un contenuto diventa difficile. I ricercatori hanno quindi scelto di cambiare prospettiva. Invece di chiedersi chi abbia scritto un testo, propongono di valutare quanto quel testo risulti sorprendente per il modello che deve imparare da esso. Il concetto scientifico si chiama perplexity, una misura statistica che indica quanto una sequenza di parole sia prevedibile per un sistema linguistico. Più il modello considera improbabile un determinato testo, maggiore è il suo livello di sorpresa. Non si tratta, naturalmente, di un'emozione: l'intelligenza artificiale non prova stupore nel senso umano del termine. È piuttosto una misura della distanza tra ciò che il sistema si aspetta di leggere e ciò che effettivamente incontra.
 Giancarlo Donadio
Per fare un esempio, davanti alla frase Il sole sorge a est, un modello linguistico ben addestrato incontrerà una sequenza estremamente familiare. Una costruzione meno convenzionale, oppure un'associazione linguistica insolita ma sensata, potrà invece risultare statisticamente meno prevedibile. Ed è proprio questa differenza a offrire nuove possibilità di apprendimento. «Un documento è sorprendente per il modello se il modello stesso l'avrebbe scritto in modo diverso», chiarisce Luca Pappalardo, ricercatore del Cnr-Isti e co-direttore dello studio. La scoperta più interessante riguarda gli effetti di questa selezione. Negli esperimenti, i testi più prevedibili si sono rivelati maggiormente associati al deterioramento delle prestazioni durante i cicli di addestramento su contenuti sintetici.
Privilegiare invece i documenti capaci di sorprendere il modello ha permesso di attenuare il fenomeno. «I testi meno sorprendenti contribuiscono di più al collasso se usati nell'addestramento del modello. Nei nostri esperimenti abbiamo dimostrato che selezionando per l'addestramento solo i documenti sorprendenti si mitiga il problema del collasso», aggiunge Pappalardo.
Naturalmente, sorprendente non significa necessariamente corretto. Un testo può risultare statisticamente imprevedibile anche perché contiene errori, sequenze casuali o informazioni prive di fondamento. La perplexity non è dunque un certificato di qualità, ma un criterio che può contribuire a migliorare la selezione dei materiali di addestramento. I risultati sono promettenti, ma non rappresentano ancora una soluzione universale al problema.
C'è però un aspetto particolarmente affascinante nella ricerca: il parallelismo con il modo in cui apprendono gli esseri umani. Anche per un bambino l'inaspettato può diventare una straordinaria occasione di conoscenza. Quando qualcosa contraddice le sue aspettative, è proprio quella discrepanza a stimolare l'attenzione e l'apprendimento.
 Redazione
«Nell'autofagia il modello smette di apprendere nuove informazioni. Reintrodurre la sorpresa nell'addestramento richiama il modo in cui i bambini imparano dagli eventi inattesi», osserva Dino Pedreschi, professore dell'Università di Pisa.
L'analogia non significa che una macchina impari esattamente come un essere umano, ma suggerisce quanto possa essere importante, anche per i sistemi artificiali, confrontarsi con informazioni diverse da quelle già conosciute.
La ricerca si inserisce in un campo di studi più ampio, quello della coevoluzione tra esseri umani e intelligenza artificiale. Le persone producono i contenuti sui quali gli algoritmi vengono addestrati, ma gli algoritmi, a loro volta, generano testi che entrano nell'ecosistema informativo e influenzano ciò che le persone leggono, scrivono e condividono. Un rapporto sempre più stretto, nel quale diventa difficile separare nettamente la produzione umana da quella artificiale.
Ed è proprio qui che il metodo proposto dai ricercatori potrebbe rivelarsi particolarmente utile. «Questo approccio non richiede di sapere se un documento è stato scritto da un umano o da una macchina e, in un'epoca in cui distinguere i due tipi di contenuto è sempre più difficile, questa proprietà è fondamentale per la strategia», sottolinea Gizem Gezici, ricercatrice della Scuola Normale Superiore. La sfida, insomma, non consiste soltanto nell'addestrare modelli sempre più grandi, alimentandoli con quantità crescenti di dati. Conta anche la qualità dell'informazione, la sua varietà e la capacità di introdurre elementi che il sistema non avrebbe generato spontaneamente. È una prospettiva che apre interrogativi importanti sul futuro dell'intelligenza artificiale e, più in generale, sull'ambiente digitale che stiamo costruendo. Se milioni di contenuti vengono prodotti seguendo gli stessi schemi linguistici, il rischio non è soltanto quello di avere macchine più ripetitive, ma anche di rendere progressivamente più uniforme il patrimonio di informazioni dal quale apprendono. La ricerca pisana suggerisce una direzione diversa: non basta accumulare conoscenza, bisogna preservarne la diversità. E forse è proprio questo il paradosso più interessante: per continuare a migliorare una tecnologia progettata per prevedere la parola successiva, potrebbe essere necessario insegnarle il valore di ciò che non riesce a prevedere.


